Teoría de probabilidades
dgonzalez
Modelos especiales
A continuación se presentan los principales conceptos teóricos de esta unidad, acompañados de ejemplos resueltos.
Introducción
En las unidades abordadas previamente a esta se han trabajado las características de variables aleatorias tanto discretas como continuas dentro de las cuales están: la función de distribución de probabilidad \(f(x)\) , para el caso discreto y la función de densidad de probabilidad para las variables continuas. En ambos casos la función de probabilidad acumulada \(F(x)\) que representa \(P(X \leq x)\), el valor esperado \(E[X]\), la varianza \(V[X]\), y en el caso de las variables conjuntas la función de distribución conjunta y la función de densidad conjunta para los casos discreto-discreto y continuo-continuo, respectivamente \(f_{_{XY}}(x,y)\). También característica de ellas como son: el valor esperado conjunto \(E[XY]\) , la covarianza \(Cov[XY]\) y el coeficiente de correlación \(\rho_{_{XY}}\) para las variables \(X\) y \(Y\).
Ahora, el siguiente modelo :
\[f(x)= \frac{1}{50}e^{-(\frac{x}{50})} \]
Llamado exponencial, puede ser estudiado y asociado a sucesos que ocurren diariamente a nuestro alrededor.
Tener una variable cuyo comportamiento se puede caracterizar tiene la ventaja de conocer fácilmente el recorrido teórico en la construcción del modelo, las propiedades, tendencias, valor esperado, varianza, función de distribución, estimadores de sus parámetros, alternativas que facilitan el cálculo de probabilidades, su afinidad con otras variables, entre otras, características que facilitan actividades como la simulación.
El siguiente diagrama presenta los principales modelo de probabilidad y sus diferentes relaciones
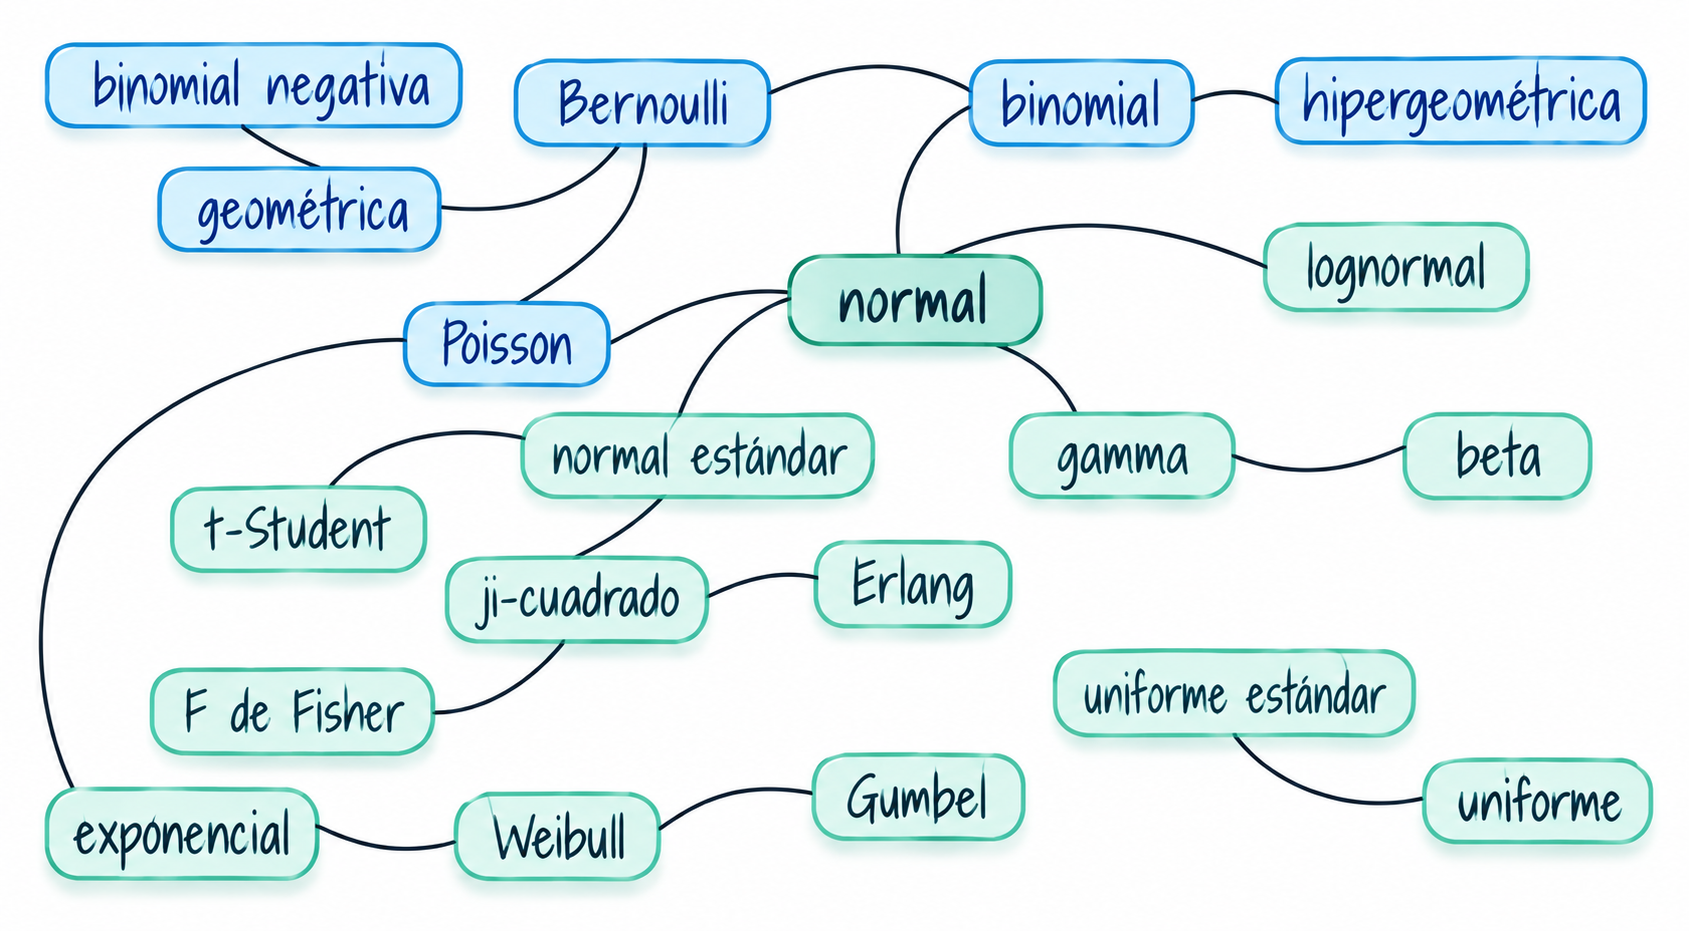
Fuente: construcción propia. basado en Univariate Distribution Relationships (Lawrence M. LEEMIS and Jacquelyn T. MCQUESTON)
Modelos continuos
Algunos modelos continuos
Las variables continuas proceden en su mayoría de la medición y se clasifican así debido a que su rango esta formado por un conjunto infinito no numerable. A continuación se presentan los principales modelos continuos.
| Uniforme | Normal | Exponencial | Gamma | Weibull | Cauchy |
| Lognormal | Beta | Erlang | Gumbel | Kernel | |
uniforme
Reseña histórica
La distribución uniforme continua no tiene un autor único. Su origen está relacionado con el principio de equiprobabilidad, según el cual, si no existe razón para favorecer un resultado sobre otro, estos pueden considerarse igualmente probables. Uno de sus principales antecedentes se encuentra en los trabajos de Pierre-Simon Laplace a finales del siglo XVIII y comienzos del XIX, quien contribuyó a formalizar esta idea dentro de la teoría clásica de la probabilidad.
Posteriormente, el desarrollo matemático de las distribuciones continuas y la axiomatización de la probabilidad realizada por Andréi Kolmogórov en 1933 permitieron establecer su formulación moderna.
Actualmente, la distribución uniforme continua es fundamental en probabilidad, estadística y simulación, especialmente en la generación de números aleatorios.
Distribución uniforme
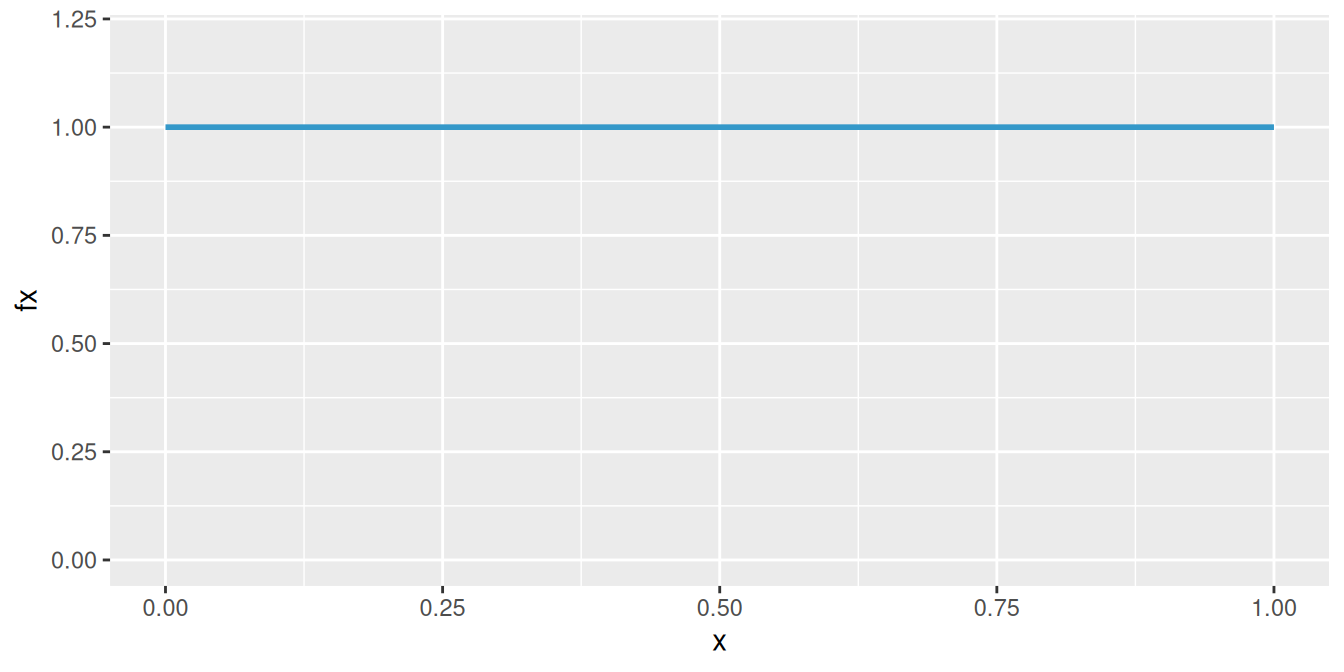
Se caracteriza porque su función de densidad es constante en su recorrido o dominio de definición (intervalo [a,b])
\[\begin{equation*} f(x)=\left\lbrace \begin{array}{lll} \dfrac{1}{b-a} &,& a \leq x \leq b \\ &&\\ 0 &,& \mbox{en otro caso} \end{array} \right. \end{equation*}\]
Distribución uniforme (\(0,1\))
Ejemplo 7
En la fabricación de portaobjetos, que son láminas rectangulares de vidrio muy delgada (76x26 mm y 1 mm de espesor), utilizados para la observación de sustancias en el microscopio. Una de sus principales características está relacionada con su espesor (\(X\)), el cual tiene una distribución uniforme entre 0.95 mm y 1.05 mm. Determine la probabilidad de que un portaobjeto determinado tenga un espesor superior a 1.03 mm.|
Solución
\[P(X\geq 1.03)= (1.05-1.03) \times \frac{1}{0.10}=0.20 \]
normal
Reseña histórica
La distribución normal tiene sus orígenes en el estudio de los juegos de azar. En 1733, Abraham de Moivre encontró una aproximación para la distribución binomial que dio origen a la forma matemática de la curva normal. Posteriormente, a comienzos del siglo XIX, Carl Friedrich Gauss utilizó esta distribución para estudiar los errores de medición en astronomía, relacionándola con el método de mínimos cuadrados. Por esta razón también se conoce como distribución gaussiana. Pierre-Simon Laplace contribuyó significativamente a su desarrollo teórico y a demostrar su importancia como aproximación de otras distribuciones. Durante los siglos XIX y XX, la distribución normal se convirtió en uno de los modelos fundamentales de la probabilidad y la estadística, especialmente para representar errores de medición y fenómenos naturales, sociales e industriales, y como fundamento de numerosos métodos de inferencia estadística.
La distribución normal es uno de los modelos más utilizados en las aplicaciones de la Estadística. Estas aplicaciones están relacionadas con:
Usos de la distribución normal
La mayoría de variables en la naturaleza, se distribuyen aproximadamente de manera normal
A partir de la distribución normal se originan las distribuciones \(t-student\), \(\chi^{2}\) y \(F\)-Fisher, utilizadas en inferencia estadística
En general la media muestral de variables que no tienen distribución normal, tiende a aproximarse a una distribución normal, a medida que el tamaño de muestra aumenta. (Teorema del Límite Central)
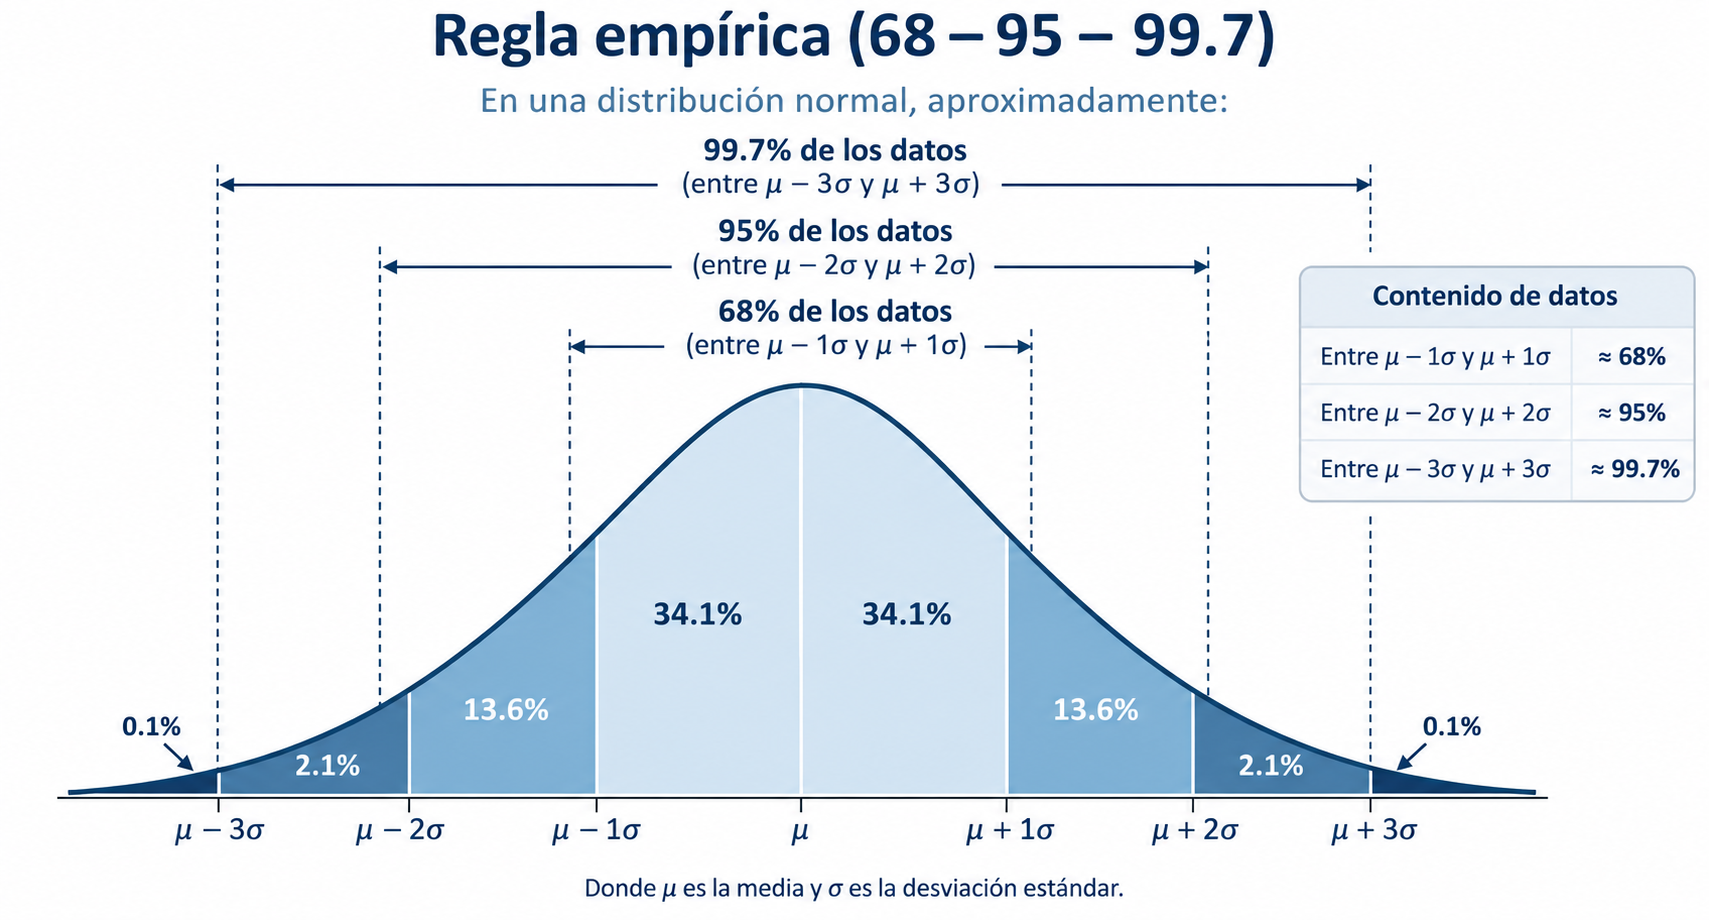
La regla empírica establece que:
Aproximadamente el 68% de la población se encuentra en el intervalo centrado \[(\mu - \sigma ; \mu + \sigma)\]
Aproximadamente el 95% de la población se encuentra en el intervalo centrado \[(\mu - 2\sigma ; \mu + 2\sigma)\]
Aproximadamente el 99.7% de la población se encuentra en el intervalo centrado \[(\mu - 3\sigma ; \mu + 3\sigma)\]
Su distribución fué planteada por el matemático francés del siglo 18, Abraham de Moivre, quien a partir de la distribución Binomial, con \(n=2\) empezó a aumentar su tamaño hasta observar que se formaba una distribución en forma de campana. Este mismo comportamiento fué detectado por Galileo en el siglo 17, al observar los errores producto de sus mediciones en astronomía. El modelo como se conoce actualmente fue propuesto de manera simultánea por los cientificos Robert Adrain y Carl Friedrich Gauss, quien finalmente le dió el nombre.
Su función de densidad esta dada por:
Distribución normal
\[f(x)= \dfrac{1}{\sqrt{2\pi \sigma^{2}}} \hspace{.1cm} e^{-\big(\frac{1}{2\sigma^{2}}(x-\mu)^{2}\big)} \hspace{.5cm} -\infty \leq x \leq \infty \]
\[E[X]=\mu\] \[V[X]=\sigma^{2}\]
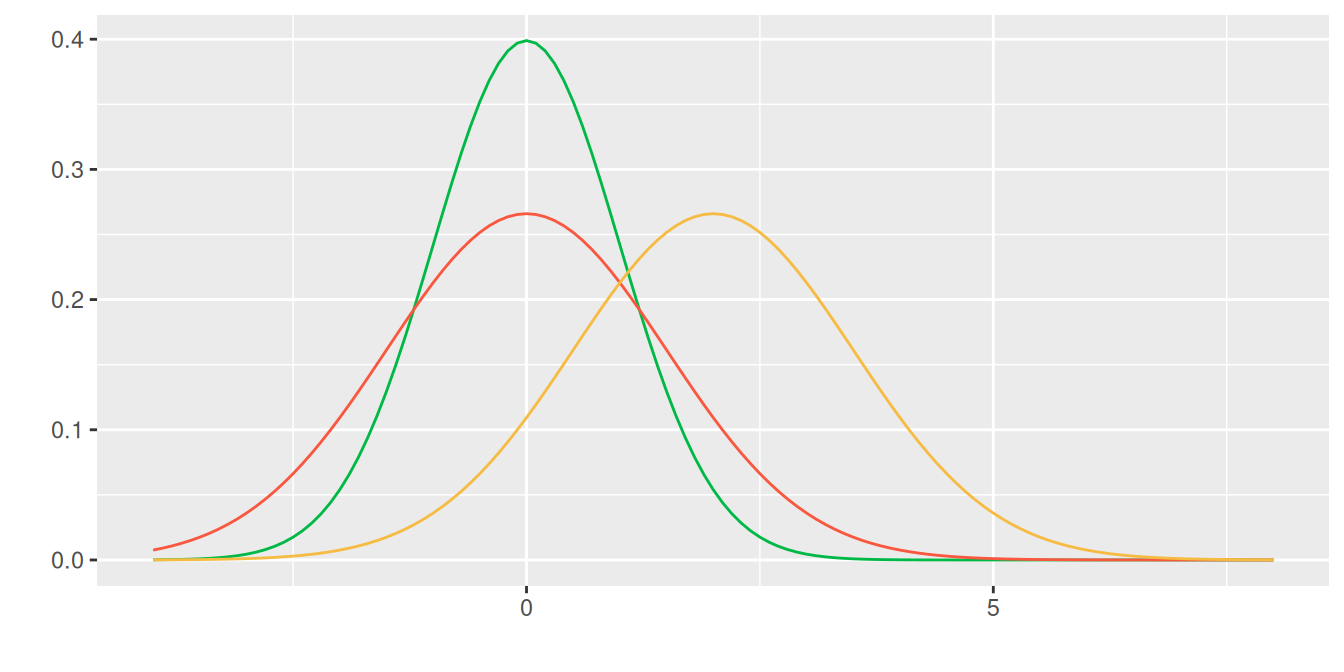
En la siguente gráfica se muestra el efecto en la curva normal, producto de cambios en la media o en la varianza. A mayor valor de la media la curva se desplaza a la derecha, mientras que a menor varianza la curva se vuelve mas angosta o puntiaguda
Distribuciones normales : \(N(0,1)\), \(N(0,1.5)\) y \(N(2,1.5)\)
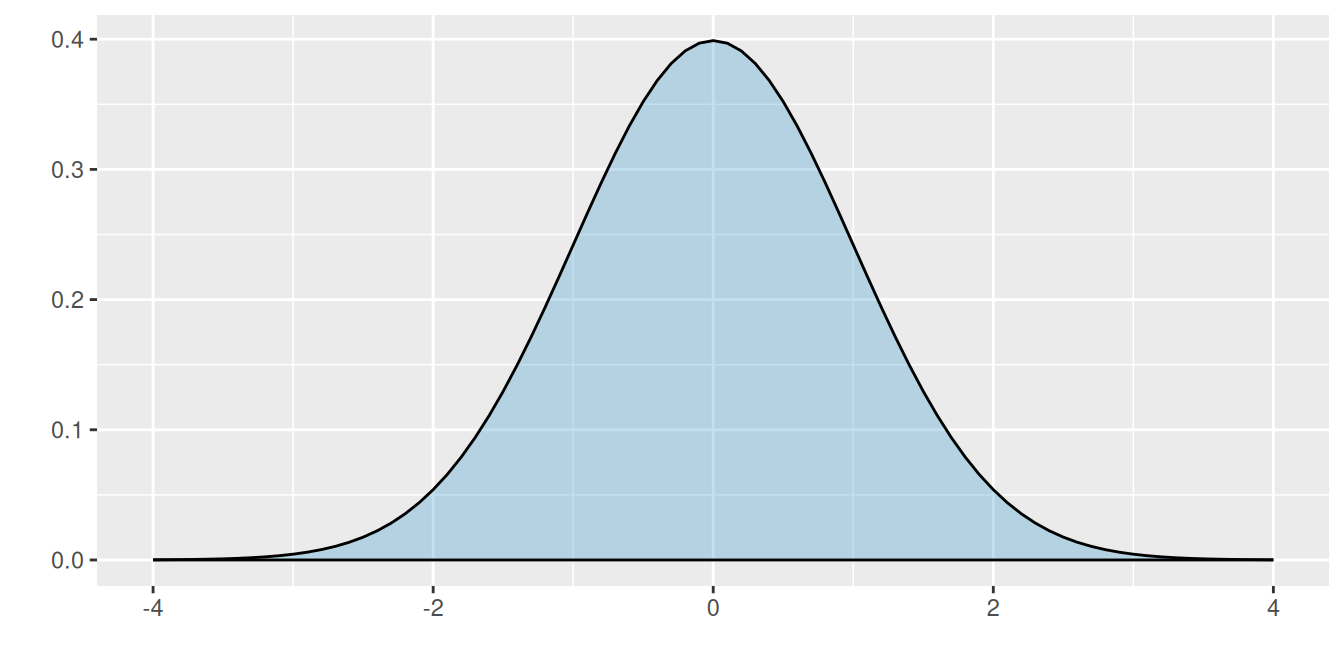
Dentro del sin número de posibles curvas que se pueden obtener con los parámetros \(\mu\) y \(\sigma^{2}\), existe una muy especial. Normal estándar (\(N(0,1)\)) con \(\mu=0\) y \(\sigma^{2}=1\). La gran mayoría de libros de Estadística poseen tablas de la función de distribución acumulada de la normal estándar.\
Distribución normal estandar N(0,1)
Su función de distribución esta dada por :
\[f(x)= \dfrac{1}{\sqrt{2\pi}} \hspace{.1cm} e^{-\big(\frac{1}{2}(x)^{2}\big)} \hspace{.5cm} -\infty \leq x \leq \infty \]
Si \(X \sim N(\mu, \sigma^{2})\), entonces \(Z= \dfrac{X-\mu}{\sigma} \sim N(0,1)\)
a este proceso se le llama comúnmente estandarizar.
normal estánda
La propiedad empírica de la distribución normal es de gran ayuda cuando una variable de interés se puede aproximar al modelo normal. Ella establece un intervalo formado por la media mas o menos una desviación estándar contiene el 68% de los datos. Si el intervalo tiene un ancho de 4 desviaciones estándar contendrá el 95% de los datos y si este intervalo corresponde a los valores de la media mas o menos 3 desviaciones estándar contendrá el 99% de los datos que se representa en la siguiente gráfica.
Propiedad empírica de la distribución normal estandar
- \(P(\mu - \sigma \leq X \mu + \sigma) = 0.68\)
- \(P(\mu - 2\sigma \leq X \mu + 2\sigma) = 0.95\)
- \(P(\mu - 3\sigma \leq X \mu + 3\sigma) = 0.99\)
Ejemplo 8
La velocidad de transferencia de archivos desde un servidor en el campus de la universidad a un ordenador personal en casa de un estudiante en un día laborable, se distribuye normalmente con una media de 60 kilobits por segundo y una desviación estándar de 4 kilobits por segundo. ¿Cuál es la probabilidad de que el archivo se transfiera a una velocidad de 70 kilobits por segundo o más?
Solución
Para una variable \(X\) con distribución \(N(60,16)\), debemos calcular la probabilidad \(P(X \geq 70)\) \
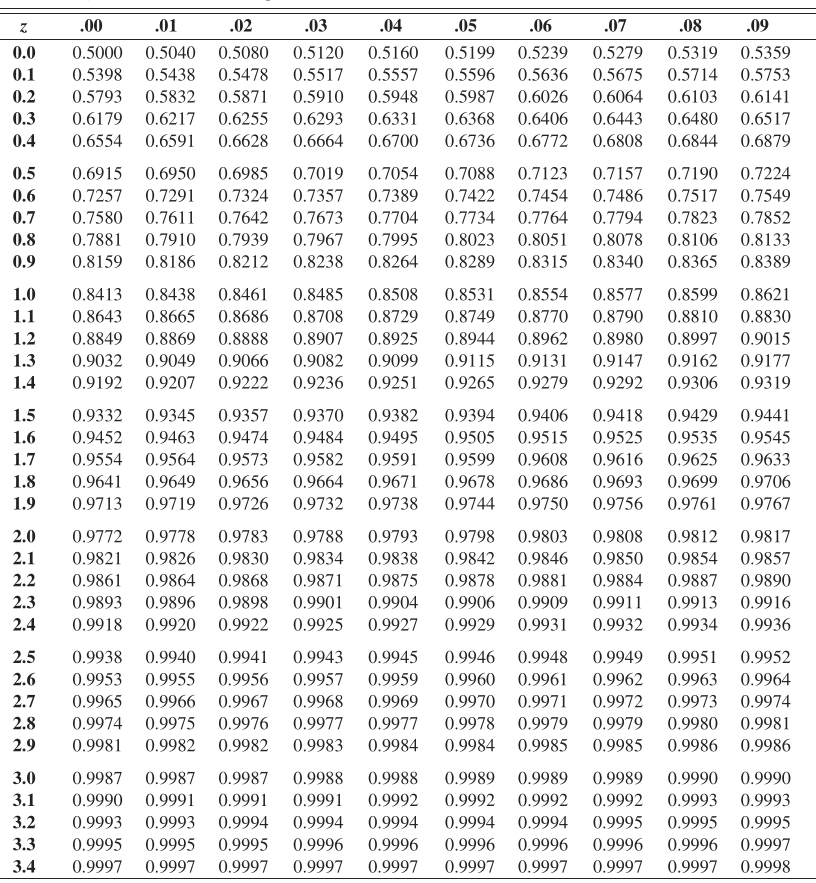
\[\begin{eqnarray*} P(X \geq 70)&=&P\Bigg(\dfrac{X-\mu}{\sigma} \geq \dfrac{70-60}{4}\Bigg)\\ &=& P\Bigg(Z \geq \dfrac{70-60}{4}\Bigg)\\ &=& P(Z\geq 2.5)=1-P(Z < 2.5 )\\ &=& 1-0.9938=0.0062 \end{eqnarray*}\]
En R se utiliza el siguiente código:
pnorm(70, mean=60, sd=4, lower.tail=FALSE)[1] 0.006209665exponencial
Reseña histórica
La distribución exponencial surgió del estudio de fenómenos relacionados con el tiempo de espera entre eventos aleatorios. Sus fundamentos están estrechamente vinculados con el desarrollo del proceso de Poisson, inspirado en los trabajos de Siméon Denis Poisson durante el siglo XIX.
Posteriormente se reconoció que, cuando los eventos ocurren de manera independiente y con una tasa promedio constante, el tiempo transcurrido entre dos eventos consecutivos puede modelarse mediante una distribución exponencial.
Durante el siglo XX adquirió gran importancia en áreas como ingeniería, confiabilidad y teoría de colas, donde se utiliza para modelar tiempos entre llegadas, duración de componentes y tiempos hasta la ocurrencia de una falla.
Una de sus características más importantes es la propiedad de falta de memoria: el tiempo que ya ha transcurrido no modifica la distribución del tiempo adicional de espera.
Distribución exponencial
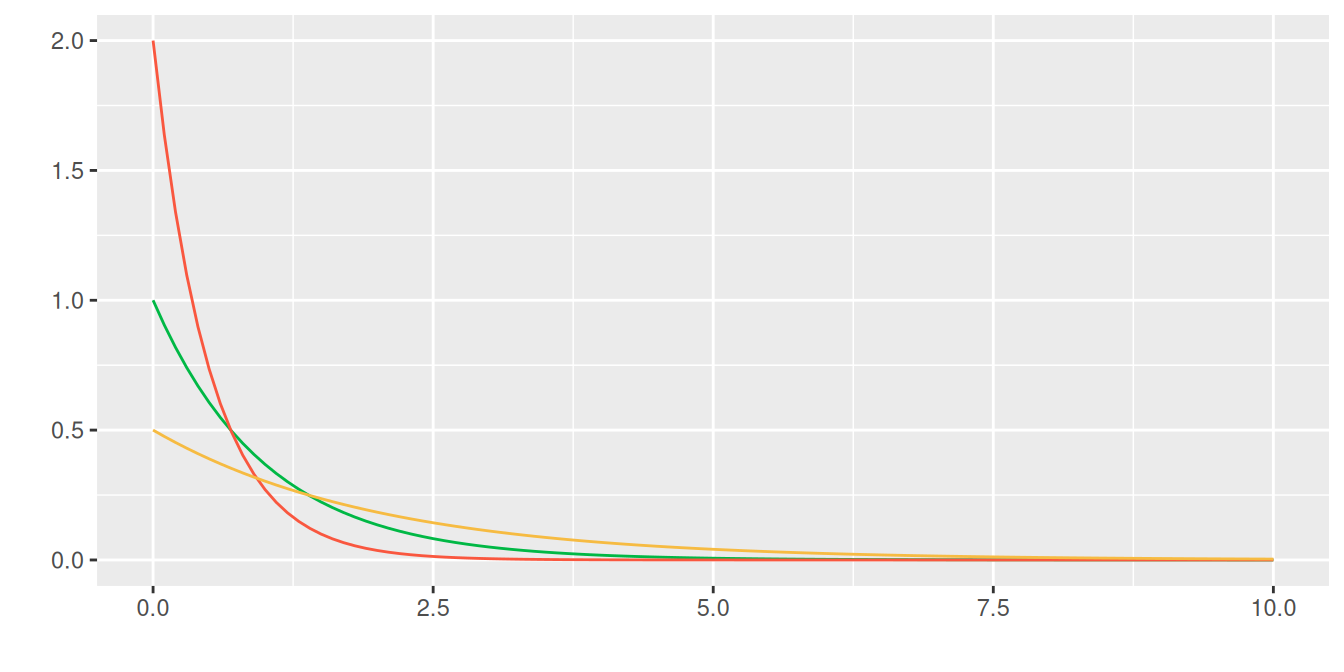
\[\begin{equation*} f(x)=\left\lbrace \begin{array}{lll} \lambda e^{-\lambda x} &,& x > 0 \\ &&\\ 0 &,& x \leq 0 \end{array} \right. \end{equation*}\]
\[E[X]=\dfrac{1}{\lambda}\]
\[V[X]=\dfrac{1}{\lambda^{2}}\]
Observación: algunos autores utilizan \(\frac{1}{\beta}\) en lugar de \(\lambda\)
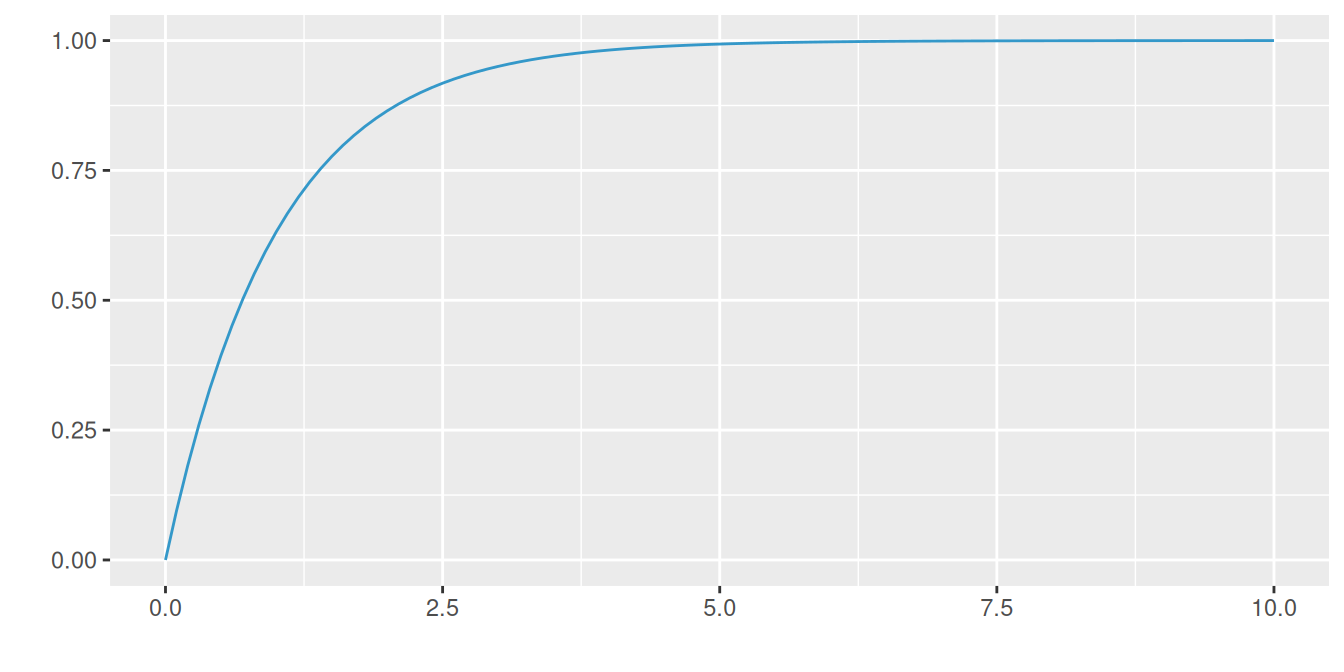
\[F(x)=P(X \leq x)=1-e^{-\lambda x} \hspace{1cm} x > 0\]
Distribuciones exponenciales : \(exp(1)\), \(exp(2)\) y \(exp(5)\)
Distribución exponencial acumulad
Ejemplo 9
El tiempo entre llamadas de los clientes a una empresa de turismo ecológico tiene una distribución exponencial con un tiempo medio entre llamadas de 15 minutos. ¿Cuál es la probabilidad de que transcurra más de 20 minutos antes de que se realiza una nueva llamada? (Ejemplo 8 4-77 Mongomery)
Solución
\(X\): el tiempo entre dos llamadas consecutivas \(\lambda=\frac{1}{15}\) minutos.
\[\begin{eqnarray} P(X \geq 20) &=& 1-P(X < 20) \\ &=& 1-(1-e^{-\frac{20}{15}}) \\ &=& 0.2636 \end{eqnarray}\]
En R se utiliza el siguiente código:
pexp(20,1/15, lower.tail=FALSE)[1] 0.2635971Para tratar las distribuciones Gamma y Weibull, es necesario definir la función Gamma como:
\[\Gamma(r)= \int_{0}^{\infty} t^{r-1} e^{t} \,dt \]
Con las siguientes propiedades:
Si \(r\) es un entero, \(\Gamma(r)=(r-1)!\)
para cualquier valor de \(r\), \(\Gamma(r+1)=r \Gamma(r)\)
\(\Gamma(1/2)=\sqrt{\pi}\)
\(\Gamma(1)=1,\hspace{.1cm} \Gamma(2)=1, \hspace{.1cm} \Gamma(3)=2, \hspace{.1cm}\Gamma(n+1)=n!\)
gamma
Reseña histórica
La distribución gamma tiene sus antecedentes en los trabajos de Leonhard Euler durante el siglo XVIII, quien estudió la función gamma como una extensión del concepto de factorial a valores no enteros. Posteriormente, esta función fue desarrollada y sistematizada por matemáticos como Adrien-Marie Legendre, quien introdujo la notación con la letra griega gamma que se utiliza actualmente. Durante el siglo XX, la función gamma dio lugar a una importante familia de distribuciones de probabilidad continuas. La distribución gamma adquirió especial relevancia para modelar tiempos de espera hasta la ocurrencia de varios eventos, generalizando así a la distribución exponencial. Actualmente tiene numerosas aplicaciones en confiabilidad, teoría de colas, hidrología, finanzas, seguros e ingeniería, especialmente para representar variables continuas positivas y asimétricas.
Distribución gamma
La distribución Gamma se obtiene al sumar \(r\) variables con distribución exponencial con parámetro \(\lambda\).
Distribución
Si \(Y=X_{1}+X_{2}+....+X_{r}\), \(X_{i} \sim Exp(\lambda)\), entonces \(Y \sim \Gamma(r,\lambda)\).
\[\begin{equation*} f(x)=\left\lbrace \begin{array}{lll} \dfrac{\lambda^{r}x^{r-1} e^{-\lambda x}}{\Gamma(r)} &,& x > 0 \\ &&\\ 0 &,& x \leq 0 \end{array} \right. \end{equation*}\]
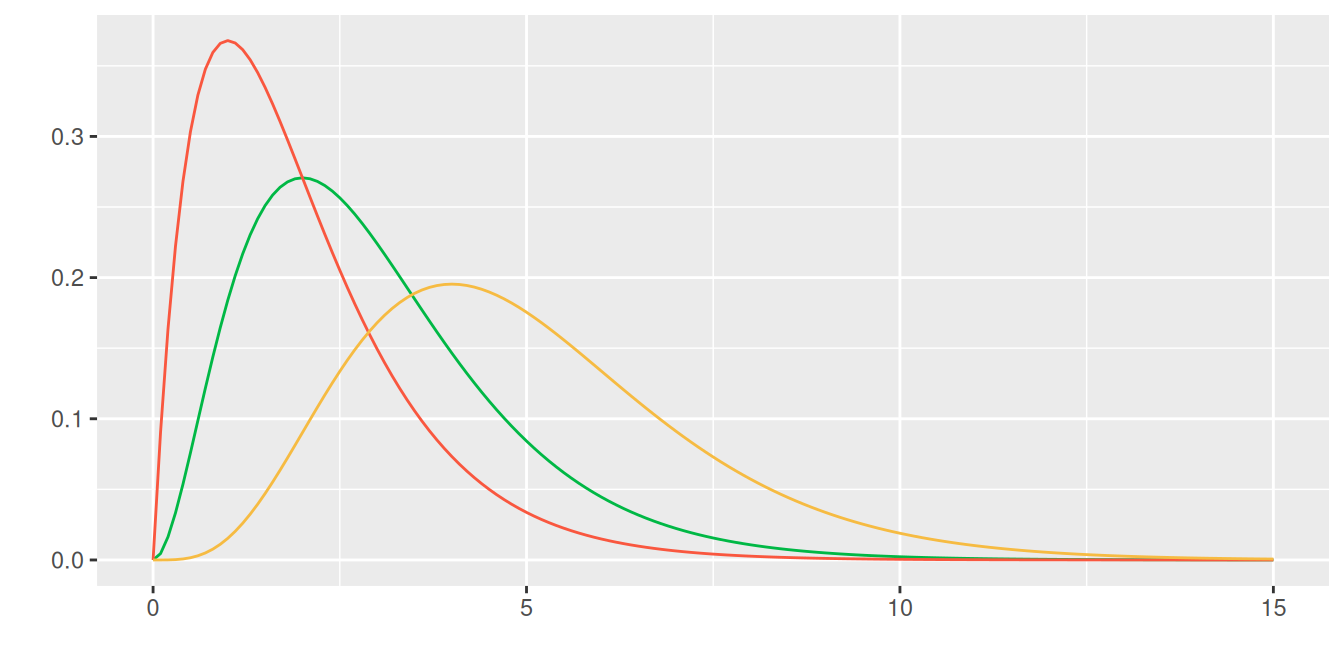
Distribuciones exponenciales gamma(3,1)}, gamma(2,1) y gamma(5,1) fig_gammas.pdf
Algunos autores utilizan \(\frac{1}{\beta}\) en lugar de \(\lambda\) y \(\alpha\) en lugar de \(r\)
\[E[X]=\dfrac{r}{\lambda}\] \[V[X]= \dfrac{r}{\lambda^{2}}\]
Distribuciones : \(gamma(3,1)\), \(gamma(2,1)\) y \(gamma(5,1)\)
Ejemplo 10
En cierta ciudad el consumo diario de energía eléctrica, en millones de kilovatios por hora, puede considerarse como una variable aleatoria con distribución Gamma de parámetros \(r= 3\) y \(\lambda= 0.5\). La planta de energía de esta ciudad tiene una capacidad diaria de 10 millones de KW/hora. ¿Cuál es la probabilidad de que este abastecimientos sea insuficiente en un día cualquiera?.
Solución
\(X\): consumo diario de energia
\[\begin{eqnarray*} P(X > 10)&=& 1-P(X \leq 10) \\ &=& 1 - \dfrac{1}{\Gamma(3)} \int_{0}^{10} (0.5)^{3} x^{3-1} e^{-0.5x} \,dx \\ &=& 0.124652 \end{eqnarray*}\]
pgamma(10,3,0.5, lower.tail = FALSE)[1] 0.124652Weibull
Reseña histórica
Esta distribución fue descubierta Maurice Frechet matemático francés y luego trabajada por Rosin y Rammler quienes en 1933 estudiaron el tamaño de una partícula y posteriormente recibe su nombre del ingeniero y matemático Waloddi Weibull . Esta distribución se utiliza para modelar el tiempo de vida de algunos componentes. La Weibull tiene dos parámetros \(\alpha\) y \(\beta\). Su función de distribución y sus principales características son:
Distribución Weibull
\[\begin{equation*} f(x)=\left\lbrace \begin{array}{lll} \Bigg(\dfrac{\alpha}{\beta}\Bigg)\Bigg(\dfrac{x}{\beta}\Bigg)^{\alpha-1}\exp{\Bigg\{-\Big(\dfrac{x}{\beta}\Big)^{\alpha}\Bigg\}}&,& x > 0\\ &&\\ 0 &,& x \leq 0 \end{array} \right. \end{equation*}\]
\[E[X]=\beta \hspace{.2cm}\Gamma\Bigg(1+\frac{1}{\alpha}\Bigg)\]
\[V[X]=\beta^{2} \Bigg(\Gamma\Bigg(1+\frac{2}{\alpha}\Bigg)- \Bigg[\Gamma \Bigg(1+\frac{1}{\alpha}\Bigg)\Bigg]^{2}\Bigg) \]
\[F(x)=1-\exp{\Big\{-\Big(\dfrac{x}{\beta}\Big)^{\alpha}\Big\}} \]
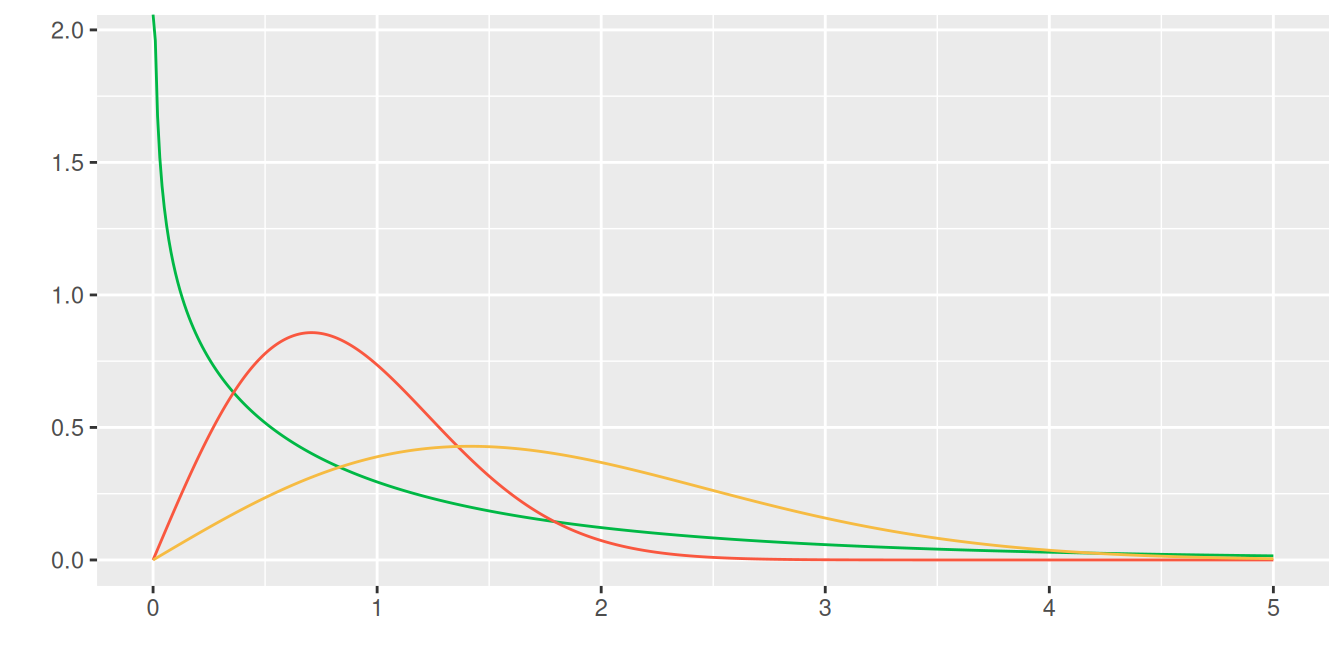
Distribuciones : \(Weibull(0.8, 1)\), \(Weibul(2,1)\) y \(Weibull(2,2)\)
Función de riesgo
Se llama así a la tasa de fallas por unidad de tiempo, expresada como la proporción de elementos que no han fallado
\[h(t)=\dfrac{f(t)}{1-F(t)} \]
Ejemplo 11
La duración de una batería se modela mediante una distribución Weibull con parámetros: \(\alpha=0.1\) y \(\beta=2\). Determine la probabilidad de que una batería dure más de 10 horas. Determine la proporción de baterías que durarán más de 10 horas.
Solución
\[\begin{eqnarray*} P(X > 10) &=& 1- F(10)\\ &=& 1-\Big(1-e^{-[10/2]^{0.1}}\Big)\\ &=& -e^{[5]^{0.1}}\\ &=& 0.3089367 \end{eqnarray*}\]
En este caso también se puede obtener la tasa de fallos esta determinada por: \[\begin{eqnarray*} h(10)&=&\dfrac{f(10)}{1-F(10)}\\ &&\\ &=& \dfrac{0.003628829}{1-0.6910633}\\ &&\\ &=& 0.01174619 \end{eqnarray*}\]
Código R
| modelo | \(F(x)\) | \(X_{p}\) | \(f(x)\) | aleatorio |
|---|---|---|---|---|
| Binomial | pbinom | qbinom | dbinom | rbinom |
| Geometrica | pgeom | qgeom | dgeom | rgeom |
| Hipergeomet. | phyper | qhyper | dhyper | rhyper |
| Poisson | ppois | qpois | dpois | rpois |
| Binomial Negativa | pnbinom | qnbinom | dnbinom | rnbinom |
| Beta | pbeta | qbeta | dbeta | rbeta |
| Cauchy | pcauchy | qcauchy | dcauchy | rcauchy |
| Chi-cuadrado | pchisq | qchisq | dchisq | rchisq |
| Exponencial | pexp | qexp | dexp | rexp |
| F | pf | qf | df | rf |
| Gamma | pgamma | qgamma | dgamma | rgamma |
| Logistic | plogis | qlogis | dlogis | rlogis |
| Log Normal | plnorm | qlnorm | dlnorm | rlnorm |
| Normal | pnorm | qnorm | dnorm | rnorm |
| t-Student | pt | qt | dt | rt |
| Uniforme | punif | qunif | dunif | runif |
| Weibull | pweibull | qweibull | dweibull | rweibull |
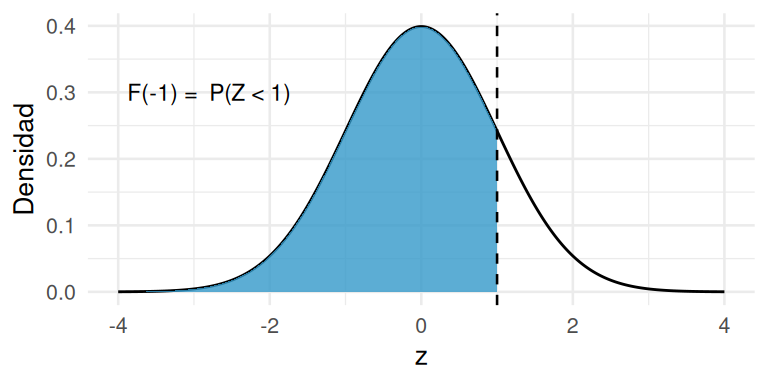
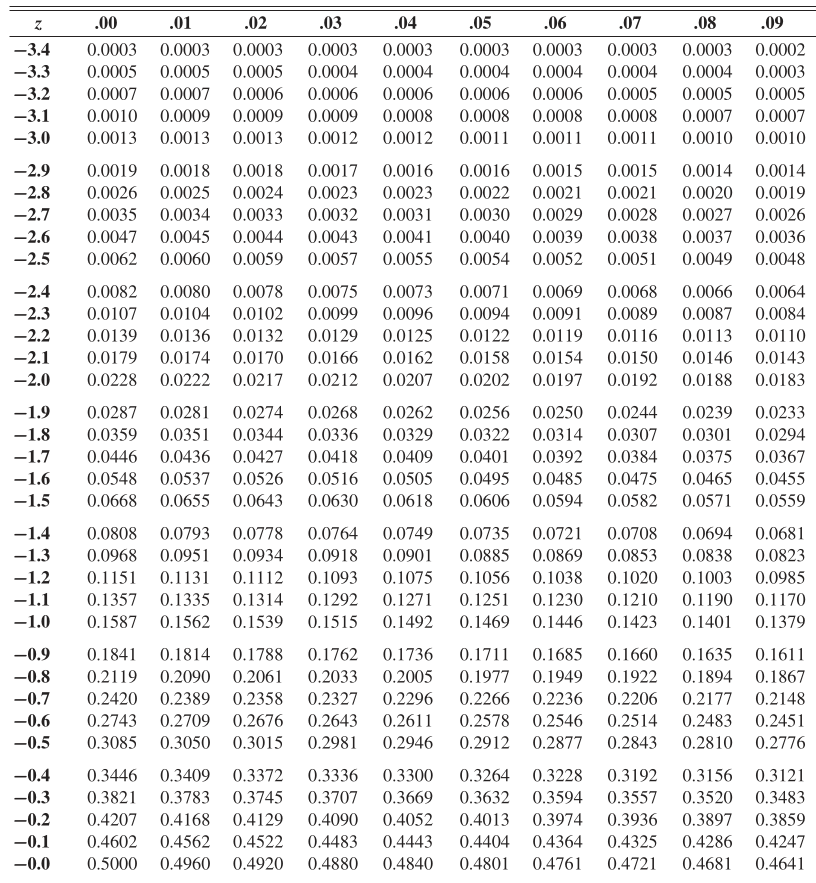
Tabla normal estandar
library(ggplot2)

# Definir rango para la curva normal
x <- seq(-4, 4, length=1000)
y <- dnorm(x)

# Valor de z
z <- -1

# Data frame para la curva
df <- data.frame(x = x, y = y)

# Data frame para el área sombreada
df_shade <- subset(df, x <= z)

# Graficar
ggplot(df, aes(x, y)) +
  geom_line(size=0.5) +
  geom_area(data = df_shade, aes(x, y), fill=c31, alpha=0.8) +
  geom_vline(xintercept = z, linetype="dashed") +
  labs(x="z", y="Densidad") +
  annotate("text", x = -2.8, y = 0.3, label = "F(-1) =  P(Z < -1)", size = 3, color="black") +
  theme_minimal(base_size = 10)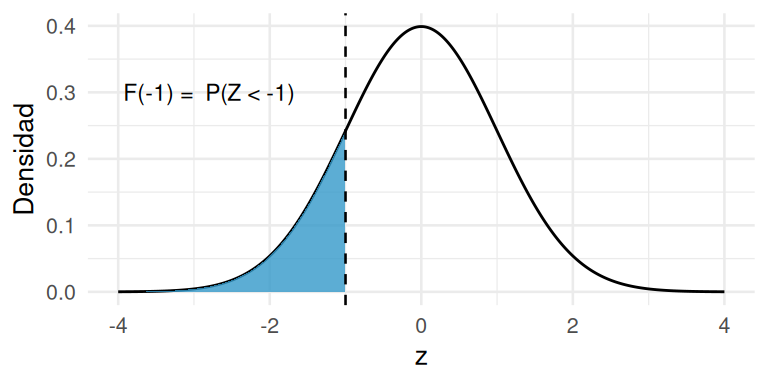
library(ggplot2)

# Definir rango para la curva normal
x <- seq(-4, 4, length=1000)
y <- dnorm(x)

# Valor de z
z <- 1

# Data frame para la curva
df <- data.frame(x = x, y = y)

# Data frame para el área sombreada
df_shade <- subset(df, x <= z)

# Graficar
ggplot(df, aes(x, y)) +
  geom_line(size=0.5) +
  geom_area(data = df_shade, aes(x, y), fill=c31, alpha=0.8) +
  geom_vline(xintercept = z, linetype="dashed") +
  labs(x="z", y="Densidad") +
  annotate("text", x = -2.8, y = 0.3, label = "F(-1) =  P(Z < 1)", size = 3, color="black") +
  theme_minimal(base_size = 10)