Teoría de probabilidades
dgonzalez
Funciones modelos
Código R
Existe un grupo de modelos identificados para las variables aleatorias tanto discretas como continuas que son utilizadas con frecuencia en diferentes contextos. A continuación se relacionan los principales modelos:
Modelos continuos:
- uniforme
- normal
- exponencial
- lognormal
- gamma
- beta
- Weibull
- Cauchy
- Gumbel
- t-Student
- Ji-cuadrado
- F de Fisher
- Empirica o Kernel
En \(R\) los nombre de las funciones diseñadas para los cálculos requeridos están conformadas por dos partes:
La primera parte es una letra que identifica el propósito de la
función.
d : función de distribución de probabilidad \(f(x)= P(X=x)\), para el caso discreto. En el caso de las variables continuas representa la función de densidad de probabilidad \(f(x)\)
p : función de probbilidad acumulada \(F(x) = P(X \leq x)\)
q : percentil \(X_p\)
r : generador de números aleatorios
La siguiene tabla presenta estas las funciones para los principales modelos tanto discretos como continuos
| modelo | \(F(x)\) | \(X_{p}\) | \(f(x)\) | aleatorio |
|---|---|---|---|---|
| beta | pbeta | qbeta | dbeta | rbeta |
| Cauchy | pcauchy | qcauchy | dcauchy | rcauchy |
| exponencial | pexp | qexp | dexp | rexp |
| gamma | pgamma | qgamma | dgamma | rgamma |
| lognormal | plnorm | qlnorm | dlnorm | rlnorm |
| normal | pnorm | qnorm | dnorm | rnorm |
| uniforme | punif | qunif | dunif | runif |
| Weibull | pweibull | qweibull | dweibull | rweibull |
| t-Student | pt | qt | dt | rt |
| Ji-cuadrado | pchisq | qchisq | dchisq | rchisq |
| F | pf | qf | df | rf |
En R los nombres de las funciones diseñadas para los cálculos requeridos están conformadas por dos partes: la primera parte con el propósito de la función (primera letra) y la segunda parte hace referencia al modelo a utilizar (d binom para el calculo de probabilidad de una variable aleatoria con distribución binomial)
En cada caso si no recuerda las sintaxis de la función puede hacer uso de las ayudas de R así:
help("pbinom")| p | función de distribución acumulada \(F(x)\) |
| q | percentil |
| d | densidad de probabilidad \(P(X=x)\) |
| r | variable aleatoria |
Ahora supongamos que se tiene una variable continua con distribución normal, con media 50 y varianza 100, es decir desviación estándar 10, lo cual se puede representar como \(X\sim N(50,100)\).
En este caso vamos a hallar los siguientes valores:
- Calcular la probabilidad de que un valor de \(X\) sea menor o igual a 70,
- Calcular la probabilidad de que la variable sea mayor a 70: \(P(X>70)\)
- Genere 10 números aleatorios de la variables \(X\)
- Generar la gráfica de la función de densidad de la variable \(X\), \(f(x)\)
- Generar la gráfica de la función de probabilidad acumulada de la variable \(X\), \(F(x)\)
Solución
- Calcular la probabilidad de que un valor de \(X\) sea menor o igual a 70,
\[ P(X<70) =\displaystyle\int_{-\infty}^{70} \dfrac{1}{\sqrt{200 \pi }} \exp{\frac{1}{200 }(x-50)^{2}} \:dx \]
pnorm(70,50,sqrt(100))[1] 0.9772499- Calcular la probabilidad de que la variable sea mayor a 70:
\[P(X>70) = \displaystyle\int_{70}^{\infty} \dfrac{1}{\sqrt{200 \pi }} \exp{\frac{1}{200 }(x-50)^{2}} \:dx \]
pnorm(70,50,sqrt(100),lower.tail=FALSE)[1] 0.02275013- Genere 10 números aleatorios de la variables \(X\)
rnorm(10,70,sqrt(100)) [1] 84.26423 81.23520 45.47243 72.78301 83.00082 69.66922 63.11758 74.99612
[9] 69.89171 70.27975- Generar la gráfica de la función de densidad de la variable \(X\), \(f(x)\)
curve(dnorm(x,50,sqrt(100)), from=0, to=100,
col="#476885", main="Distribución Normal(50,100)",
ylab="f(x)", las=1)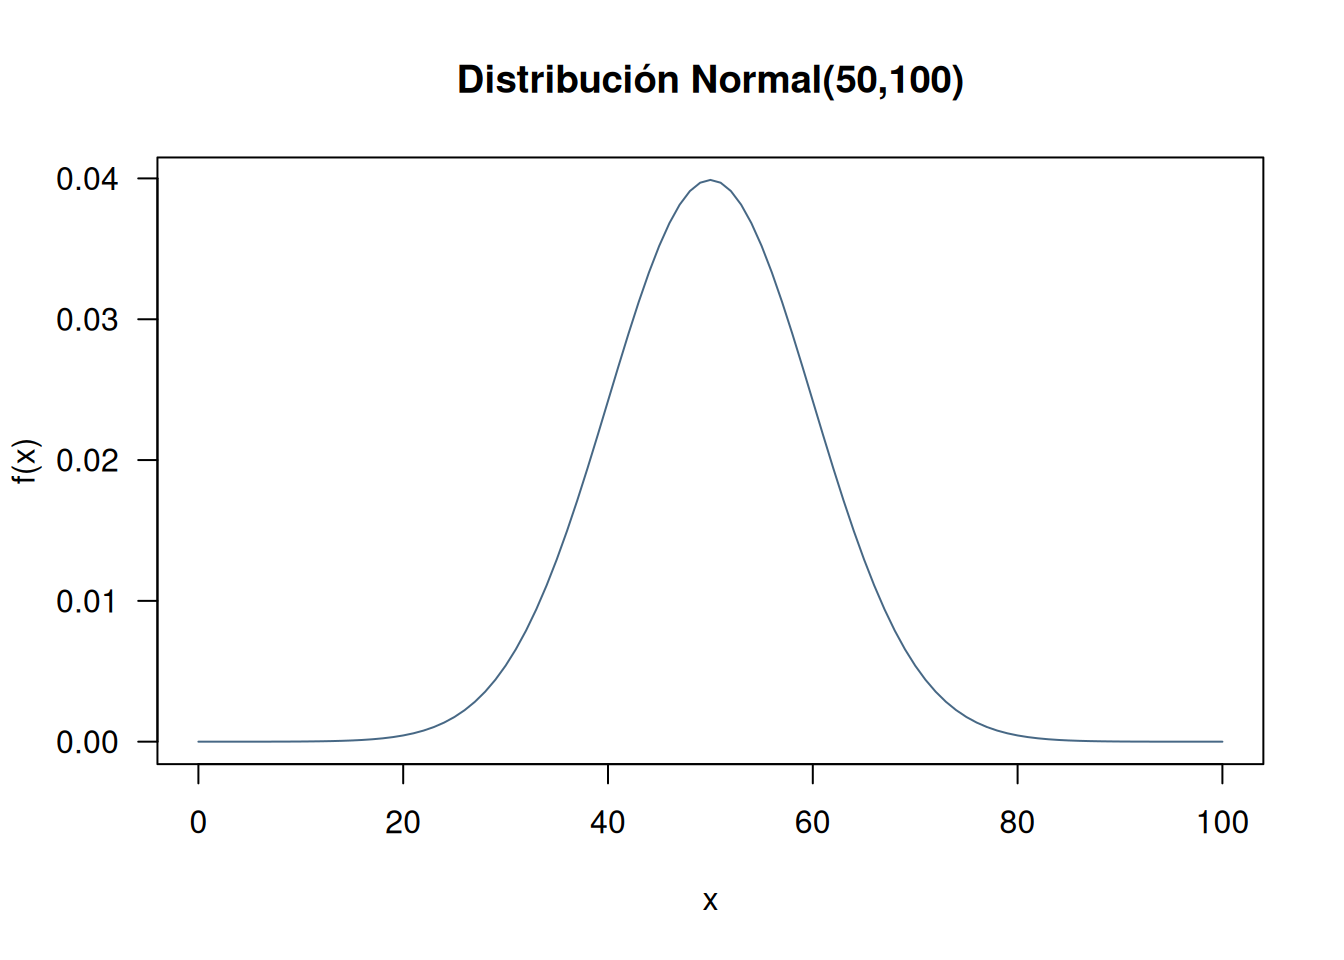
- Generar la gráfica de la función de probabilidad acumulada de la variable \(X\), \(F(x)\)
curve(pnorm(x,50,sqrt(100)), from=20, to=80,
col="#476885", main="Distribución Normal(50,100)",las=1,
ylab="f(x)")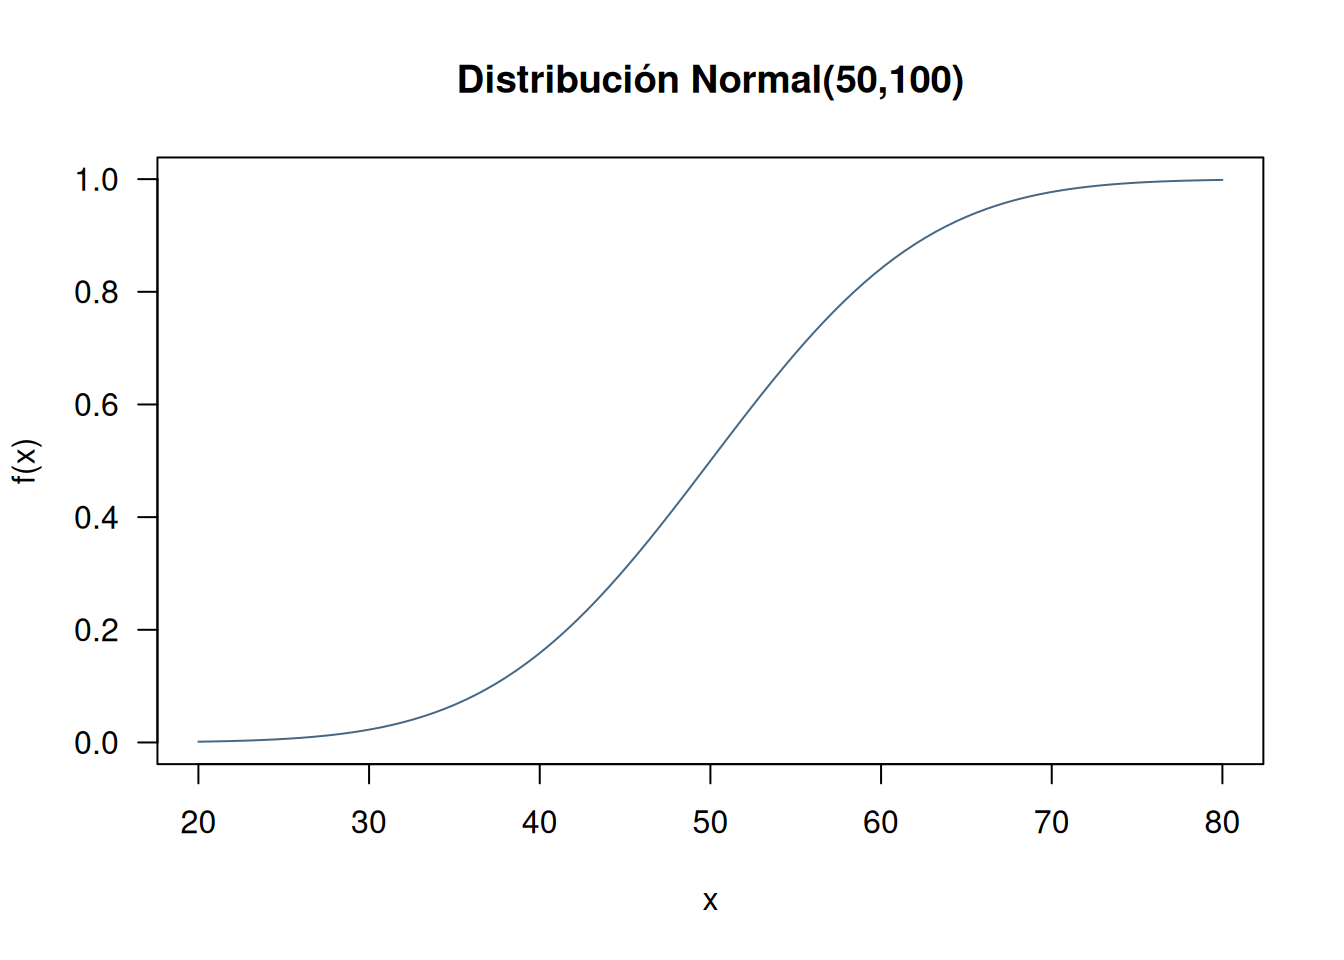
Código
# install.package("ggfortify")
library(ggfortify)
ggdistribution(dnorm, seq(-4, 4, 0.1), mean = 0, sd = 1,fill = c31)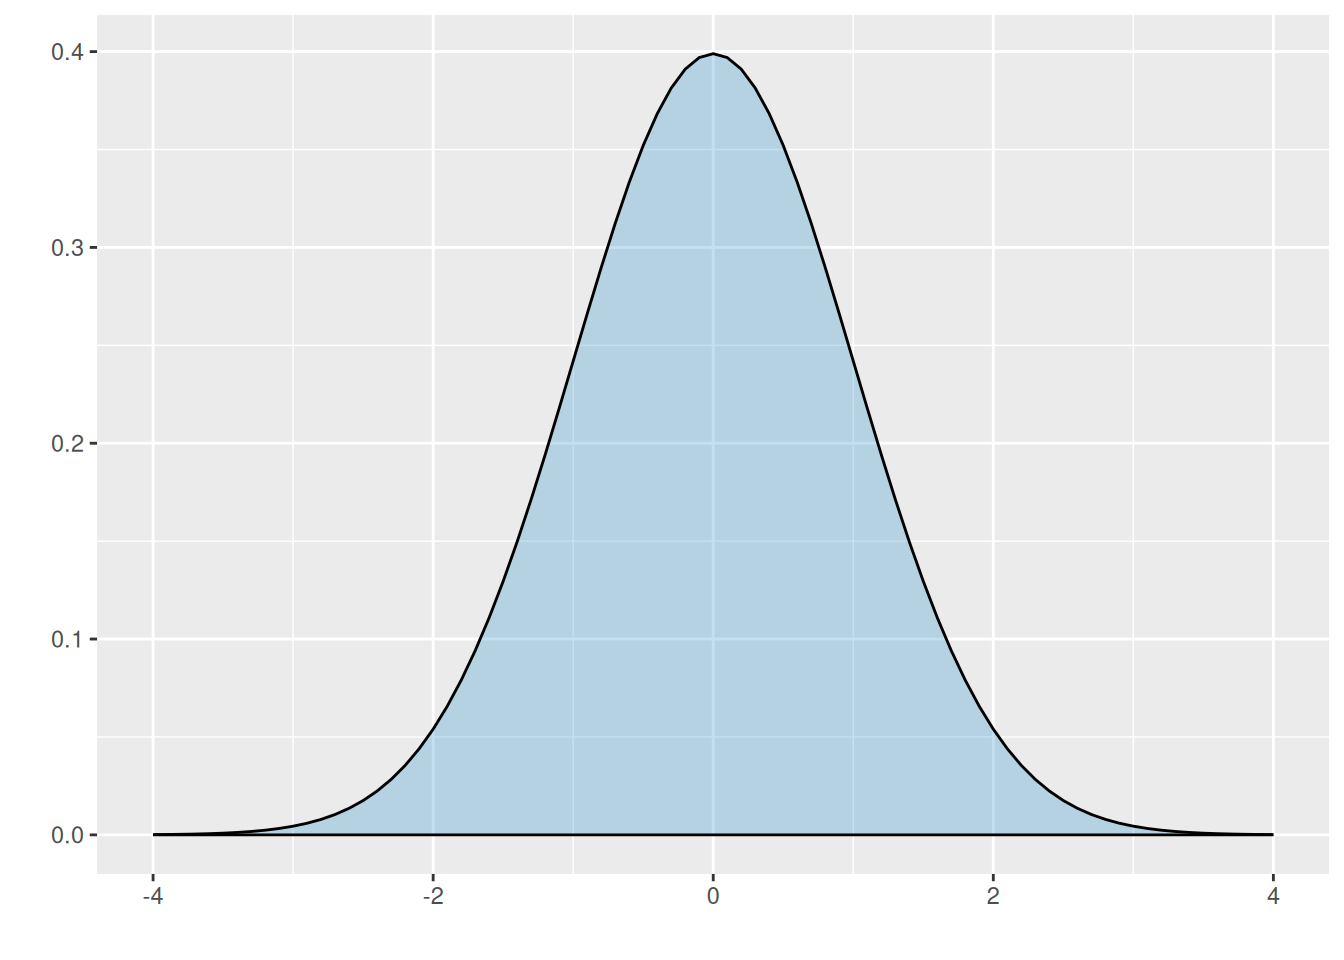
# install.package("ggfortify")
library(ggfortify)
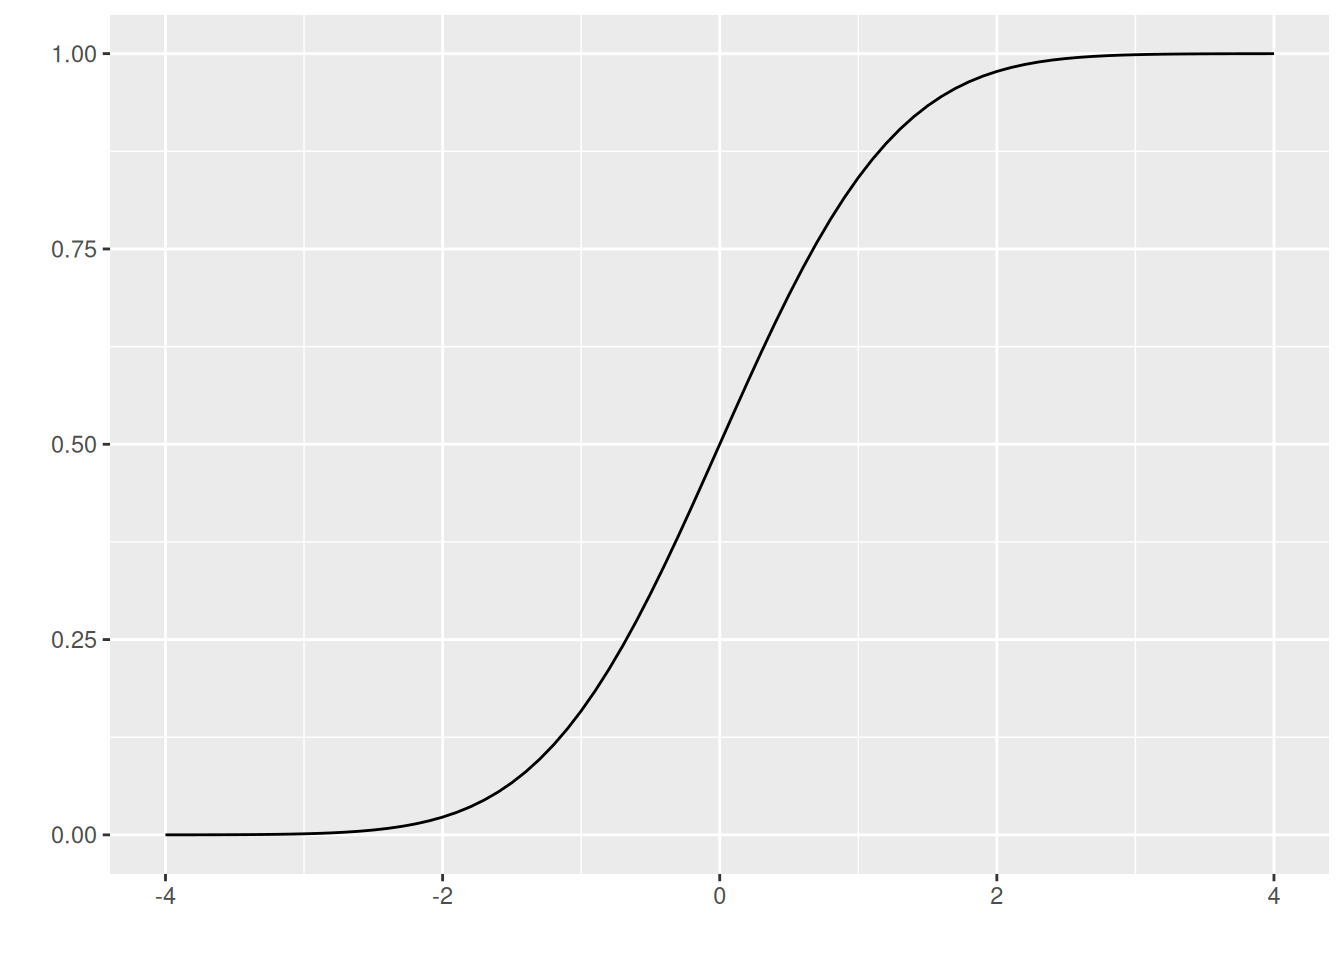
ggdistribution(pnorm, seq(-4, 4, 0.1), mean = 0, sd = 1)